distinct
distinct
https://segmentfault.com/q/1010000007659294
我创建了一个分成两个节点的List
1 | val list = sc.parallelize(List(1,1,1,1,2,2,2,3,3,4),2) |
现在对其进行distinct操作
1 | list.distinct.collect |
执行时的DAG图如下所示

spark 不同stage 之间的划分原则是是否有shuffle操作。
这里的不是进行了两次 distinct操作,而是一个distinct操作被划分为两个stage,因为有distinct操作需要shuffle。
如果你仔细看stage0的话,你会发现这里进行的distinct 是mapPartitions。

distinct算子的原理
- 首先,自己先给每个值打上一个v2,变成一个tuple
- reduceByKey(…仅仅返回一个value)
- 将去重后的数据,从tuple还原为单值
spark部分:distinct去重的原理
2018-08-27 13:13:52 更多
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。本文链接:https://blog.csdn.net/wyqwilliam/article/details/82110860

spark-groupByKey
一般来说,在执行shuffle类的算子的时候,比如groupByKey、reduceByKey、join等。 其实算子内部都会隐式地创建几个RDD出来。那些隐式创建的RDD,主要是作为这个操作的一些中间数据的表达,以及作为stage划分的边界。 因为有些隐式生成的RDD,可能是ShuffledRDD,dependency就是ShuffleDependency,DAGScheduler的源码,就会将这个RDD作为新的stage的第一个rdd,划分出来。
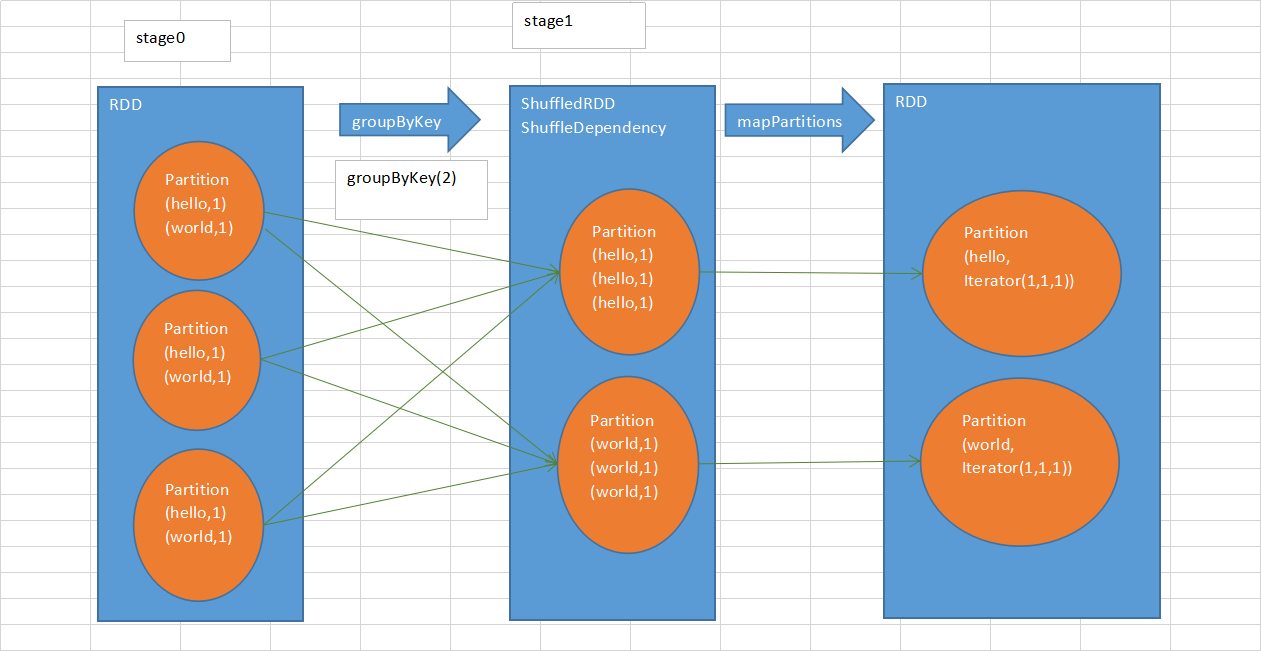
groupByKey等shuffle算子,都会创建一些隐式RDD。比如说这里,ShuffledRDD,作为一个shuffle过程中的中间数据的代表。 依赖这个ShuffledRDD创建出来一个新的stage(stage1)。ShuffledRDD会去触发shuffle read操作。从上游stage的task所在节点,拉取过来相同的key,做进一步的聚合。 对ShuffledRDD中的数据执行一个map类的操作,主要是对每个partition中的数据,都进行一个映射和聚合。这里主要是将每个key对应的数据都聚合到一个Iterator集合中。
reduceByKey算子内部实现原理
https://www.jianshu.com/p/89caca18ba9b
先看原理图

我们可以这样写:
1 | val word = rdd1.reduceByKey((x,y) => x+y) |
对上述的写法简化一下:
1 | val word= rdd1.reduceByKey(_+_) |
reduceByKey会寻找相同key的数据,当找到这样的两条记录时会对其value(分别记为x,y)做(x,y) => x+y的处理,即只保留求和之后的数据作为value。反复执行这个操作直至每个key只留下一条记录。
如果觉得简化后的写法比较难易理解,先看不简化之前的写法是这样理解的,以上面的数据集为例,从左到右第一个hello这个key对应的值是1,这个1就是不简化写法之前的x,然后继续找从左到右第五个又是hello,那么第二个找到的helloKey对应的value是2,这个2就是不简化写法之前的y。然后reduceByKey就对当前找到的这两个相同的key的value做一个加法,然后得到一个新的key-value,这个新的的key-value的key就是hello而value就是相加以后的结果3,然后继续找第三个key为hello的单词,找到以后和刚才相加以后得到的新的hello:3继续相加,此时你可以把之前相加得到的3作为x,把找到的第三个key为hello的单词对应的value作为y,然后继续相加,再得到第二个新的key-vlaue,这个第二个新的key-vlaue的key为hello,value为4,然后这个第二个新的vlaue4又作为x,然后在继续找其他的相同的key,找到后以此类推。
而简化以后的写法第一个_下划线就代表x,第二个_下划线代表y。然后原理就是上面写的.
reduceByKey,跟groupByKey有一些异同之处
- 不同之处:reduceByKey,多了一个rdd,MapPartitionsRDD,存在于stage0的,主要是代表了进行本地数据归约之后的rdd。所以,要网络传输的数据量,以及磁盘IO等,会减少,性能更高。
- 相同之处:后面进行shuffle read和聚合的过程基本和groupByKey类似。都是ShuffledRDD,去做shuffle read。然后聚合,聚合后的数据就是最终的rdd。wordCounts rdd。